第二章的知识「相比第一章来说会更加抽象 一些,同学们上课和课后一定要多花时间复习……学习的时候先接受它,然后再求理解」(00:24:58)。2.1 节备好了映射的语言,抽象的起点就是本节:给映射加上与线性运算相容的要求——可加性 + 齐次性 = 线性映射 (定义 2.2.1 )。定义之后清点十二个例子(从零变换到微分、积分、投影、坐标与转置),再从例子里提炼三条核心性质(保持线性组合 定理 2.2.1 、T ( θ ) = θ ′ T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = θ ′ 推论 2.2.1 )与单射判据 (定理 2.2.2 )及其推论。最后把「所有线性映射」装进一个线性空间 L ( V , W ) L(V,W) L ( V , W ) 定理 2.2.3 ),并以零空间 / 值域与亏加秩定理 (定理 2.2.5 )收束本讲。
图解 读图: 把 x 拆成两半:x_row 落在行空间里,被 A 同构地送到列空间;x_null 落在核里,被 A 直接压成 0。于是「A 的像」只由 x_row 决定,秩与零空间维数的账本也就自然成立。
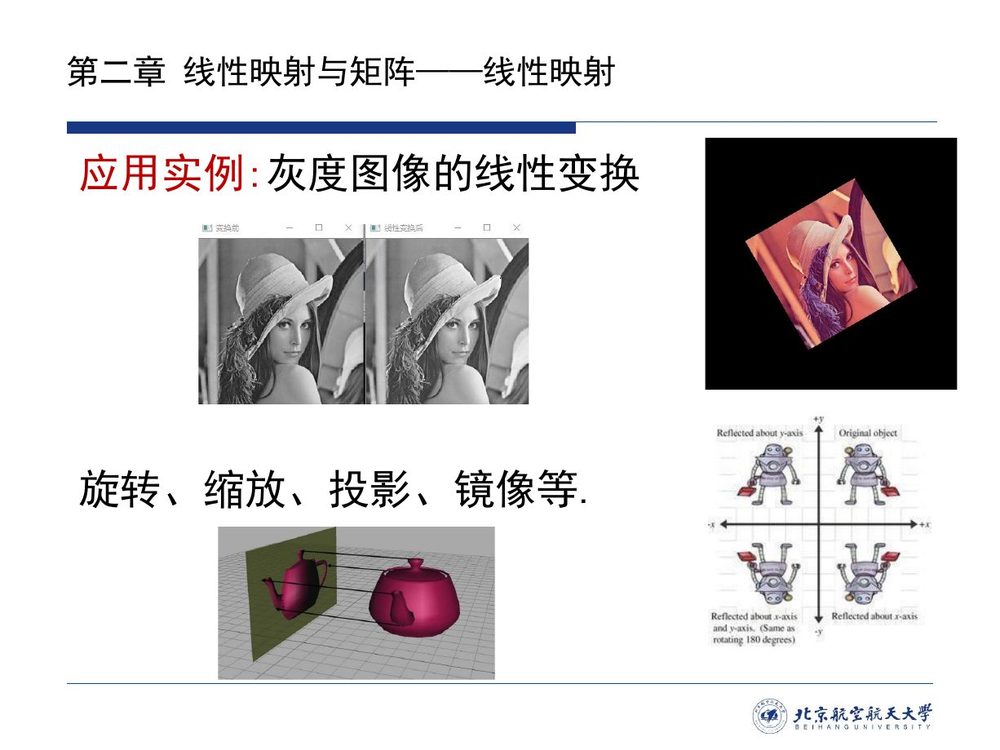
课件用一整页的应用实例 开场(本编补录):灰度图像的旋转、缩放、投影、镜像,都是把像素坐标做线性变换——「线性映射不是抽象游戏,图像处理里每一步都在用」。
图像处理里的这些操作有一个共同点:它们只用到坐标的线性运算。把这个共同点抽成一般的要求,就是本节的第一个定义。
定义 2.2.1 · 线性映射(线性变换)
设 V V V W W W F F F T : V → W T:V\to W T : V → W
可加性 :∀ x , y ∈ V \forall x,y\in V ∀ x , y ∈ V T ( x + y ) = T ( x ) + T ( y ) T(x+y)=T(x)+T(y) T ( x + y ) = T ( x ) + T ( y ) 齐次性 :∀ λ ∈ F \forall\lambda\in F ∀ λ ∈ F T ( λ x ) = λ T ( x ) T(\lambda x)=\lambda T(x) T ( λ x ) = λ T ( x )
则称 T T T V V V W W W 线性映射 。特别地,当 V = W V=W V = W T T T V V V T T T V V V 线性变换(或线性算子) 。
上面两条要求还可以合并成一条等价形式,实际判定时几乎都直接用它(课件给出):
T ( a x + b y ) = a T ( x ) + b T ( y ) , ∀ x , y ∈ V , ∀ a , b ∈ F . T(ax+by)=aT(x)+bT(y),\qquad \forall x,y\in V,\ \forall a,b\in F . T ( a x + b y ) = a T ( x ) + b T ( y ) , ∀ x , y ∈ V , ∀ a , b ∈ F .
两条注记(00:27:03–00:29:31,老师逐条讲)
V V V W W W F F F λ x \lambda x λ x λ T ( x ) \lambda T(x) λ T ( x ) λ \lambda λ 两套运算不要混 :「x + y x+y x + y λ x \lambda x λ x V V V T ( x ) + T ( y ) T(x)+T(y) T ( x ) + T ( y ) λ T ( x ) \lambda T(x) λ T ( x ) W W W = = = + + +
「保持线性运算」
上一章说线性空间 = 集合 + 加法 + 数乘。线性映射要做的事就一句话:把 V V V W W W 。即「先算后映 = 先映后算」。所以线性映射=两个线性空间之间的「结构同态」。
定义只有两行,判断力却要靠例子来养。下面按由简到繁的顺序清点十二个例子:前几个几乎不用动笔,越往后越接近考试里真正要判的形态。
(1)三个基本变换 (例 2.2.1,T : V → V T:V\to V T : V → V
T ( x ) = θ ( 零变换 ) ; T ( x ) = x ( 恒等变换 ) ; T ( x ) = − x ( 负变换 ) T(x)=\boldsymbol{\theta}\ (\text{零变换});\qquad T(x)=x\ (\text{恒等变换});\qquad T(x)=-x\ (\text{负变换}) T ( x ) = θ ( 零变换 ) ; T ( x ) = x ( 恒等变换 ) ; T ( x ) = − x ( 负变换 )
(2)平面上的三种几何变换 (例 2.2.2,T : R 2 → R 2 T:\mathbb R^2\to\mathbb R^2 T : R 2 → R 2
T ( x ) = [ k 1 0 0 k 2 ] x ( 伸缩 , k 1 , k 2 > 0 ) ; T ( x ) = [ x 1 − x 2 ] ( 反射 ) ; T ( x ) = [ cos φ − sin φ sin φ cos φ ] x ( 旋转 ) T(x)=\begin{bmatrix}k_1&0\0&k_2\end{bmatrix}x\ (\text{伸缩},\ k_1,k_2>0);\qquad T(x)=\begin{bmatrix}x_1\-x_2\end{bmatrix}\ (\text{反射});\qquad T(x)=\begin{bmatrix}\cos\varphi&-\sin\varphi\ \sin\varphi&\cos\varphi\end{bmatrix}x\ (\text{旋转}) T ( x ) = [ k 1 0 0 k 2 ] x ( 伸缩 , k 1 , k 2 > 0 ) ; T ( x ) = [ x 1 − x 2 ] ( 反射 ) ; T ( x ) = [ cos φ sin φ − sin φ cos φ ] x ( 旋转 )
平移为什么不是线性变换(老师借 推论 2.2.1 专门辨析,00:57:04–00:58:30)
T ( x ) = [ x 1 + a x 2 + b ] T(x)=\begin{bmatrix}x_1+a\\x_2+b\end{bmatrix} T ( x ) = [ x 1 + a x 2 + b ] a , b a,b a , b 0 0 0 不是 线性映射:它把原点搬到 ( a , b ) (a,b) ( a , b ) 必须保持原点不动 (T ( θ ) = θ ′ T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = θ ′ 推论 2.2.1 (1))。所以「解析几何中常见的平移变换一般不是线性变换」;绕原点 旋转才是。
几何之外,微积分里最常用的两个算子也是线性的。
(3)微分变换 (例 2.2.3):在多项式空间 P n ( x ) P_n(x) P n ( x )
T ( p ( x ) ) = d p ( x ) d x , ∀ p ( x ) ∈ P n ( x ) . T(p(x))=\frac{\mathrm dp(x)}{\mathrm dx},\qquad \forall p(x)\in P_n(x). T ( p ( x )) = d x d p ( x ) , ∀ p ( x ) ∈ P n ( x ) .
老师特别提醒(00:33:50–00:34:15):同一个微分变换既可以看作 P n → P n P_n\to P_n P n → P n P n → P n − 1 P_n\to P_{n-1} P n → P n − 1 「会出现一个降维」 ,考试时「千万千万注意题目到底怎么写的」。
(4)积分变换 (例 2.2.4):在 C [ a , b ] C[a,b] C [ a , b ]
T ( f ( x ) ) = ∫ a x f ( t ) d t , ∀ f ( x ) ∈ C [ a , b ] . T(f(x))=\int_a^x f(t),\mathrm dt,\qquad \forall f(x)\in C[a,b]. T ( f ( x )) = ∫ a x f ( t ) d t , ∀ f ( x ) ∈ C [ a , b ] .
下一个例子把第一章的内积结构直接变成一个线性变换。
(5)正交投影变换 (例 2.2.5):设 V V V 内积空间 、W W W V V V T ( x ) = Proj W x T(x)=\operatorname{Proj}_W x T ( x ) = Proj W x ∀ x ∈ V \forall x\in V ∀ x ∈ V T T T V V V V V V 1.6 勘误 E11)。若 α 1 , ⋯ , α n \alpha_1,\cdots,\alpha_n α 1 , ⋯ , α n W W W 1.6 的投影公式可以照搬:
T ( x ) = Proj W x = ( x , α 1 ) α 1 + ⋯ + ( x , α n ) α n . T(x)=\operatorname{Proj}_W x=(x,\alpha_1)\alpha_1+\cdots+(x,\alpha_n)\alpha_n . T ( x ) = Proj W x = ( x , α 1 ) α 1 + ⋯ + ( x , α n ) α n .
「V → V V\to V V → V
「明明 V V V W W W 变换 ?——因为 W ⊂ V W\subset V W ⊂ V W W W V V V V V V V = W V=W V = W V V V
接着的两个例子换一批原料——第一章的「基」与矩阵运算。
(6)两组基给出的变换 (例 2.2.6):设 V V V F F F ε 1 , ⋯ , ε n \varepsilon_1,\cdots,\varepsilon_n ε 1 , ⋯ , ε n η 1 , ⋯ , η n \eta_1,\cdots,\eta_n η 1 , ⋯ , η n V V V 两组基 ,定义映射 T : V → V T:V\to V T : V → V
T ( x ) = [ η 1 , ⋯ , η n ] [ x 1 , ⋯ , x n ] T , ∀ x ∈ V , T(x)=[\eta_1,\cdots,\eta_n],[x_1,\cdots,x_n]^{\mathrm T},\qquad \forall x\in V, T ( x ) = [ η 1 , ⋯ , η n ] [ x 1 , ⋯ , x n ] T , ∀ x ∈ V ,
式中 [ x 1 , ⋯ , x n ] T [x_1,\cdots,x_n]^{\mathrm T} [ x 1 , ⋯ , x n ] T x x x ε 1 , ⋯ , ε n \varepsilon_1,\cdots,\varepsilon_n ε 1 , ⋯ , ε n T T T V V V
这个例子的几何图像
T T T x x x 在旧基 ε \varepsilon ε 当作新基 η \eta η ,重新组装出一个向量 T ( x ) T(x) T ( x ) η \eta η T ( x ) T(x) T ( x ) 恰好是 x x x ε \varepsilon ε T ( x ) = [ η 1 ⋯ η n ] [ x 1 ⋮ x n ] T(x)=[\eta_1\cdots\eta_n]\begin{bmatrix}x_1\\\vdots\\x_n\end{bmatrix} T ( x ) = [ η 1 ⋯ η n ] x 1 ⋮ x n 同一个坐标数组配不同基,得到的是不同向量 。
(7)转置与矩阵左乘 (课件思考题与课堂补充)。∀ A ∈ R m × n \forall A\in\mathbb R^{m\times n} ∀ A ∈ R m × n T ( A ) = A T T(A)=A^{\mathrm T} T ( A ) = A T T : R m × n → R n × m T:\mathbb R^{m\times n}\to\mathbb R^{n\times m} T : R m × n → R n × m T T T 先证它是映射 (定义域、值域对不对),再验证可加性与齐次性 」:
( A + B ) T = A T + B T , ( k A ) T = k A T . (A+B)^{\mathrm T}=A^{\mathrm T}+B^{\mathrm T},\qquad (kA)^{\mathrm T}=kA^{\mathrm T}. ( A + B ) T = A T + B T , ( k A ) T = k A T .
同理 T ( X ) = A X B T(X)=AXB T ( X ) = A XB A , B A,B A , B
(8)例题(去年考题,例 2.2.7,00:53:38「这道题去年考试考过」) :
例 2.2.7(课件原文)· 由基定义的线性变换
设 α 1 , α 2 , α 3 \alpha_1,\alpha_2,\alpha_3 α 1 , α 2 , α 3 V V V T T T
T ( k 1 α 1 + k 2 α 2 + k 3 α 3 ) = ( k 1 + k 2 + k 3 ) α 1 + ( k 2 + k 3 ) α 2 + k 3 α 3 , k 1 , k 2 , k 3 ∈ F . T(k_1\alpha_1+k_2\alpha_2+k_3\alpha_3)=(k_1+k_2+k_3)\alpha_1+(k_2+k_3)\alpha_2+k_3\alpha_3,\qquad k_1,k_2,k_3\in F . T ( k 1 α 1 + k 2 α 2 + k 3 α 3 ) = ( k 1 + k 2 + k 3 ) α 1 + ( k 2 + k 3 ) α 2 + k 3 α 3 , k 1 , k 2 , k 3 ∈ F .
(1) 证明映射 T T T V → V V\to V V → V β 0 = 2 α 1 + α 2 + 3 α 3 \beta_0=2\alpha_1+\alpha_2+3\alpha_3 β 0 = 2 α 1 + α 2 + 3 α 3 T ( β 0 ) T(\beta_0) T ( β 0 )
解答 · 例 2.2.7
(1) 分两步——先证 T T T :V V V ( k 1 , k 2 , k 3 ) (k_1,k_2,k_3) ( k 1 , k 2 , k 3 ) ( k 1 + k 2 + k 3 ) α 1 + ( k 2 + k 3 ) α 2 + k 3 α 3 ∈ V (k_1+k_2+k_3)\alpha_1+(k_2+k_3)\alpha_2+k_3\alpha_3\in V ( k 1 + k 2 + k 3 ) α 1 + ( k 2 + k 3 ) α 2 + k 3 α 3 ∈ V T : V → V T:V\to V T : V → V 再证线性 :取 x = ∑ x i α i x=\sum x_i\alpha_i x = ∑ x i α i y = ∑ y i α i y=\sum y_i\alpha_i y = ∑ y i α i λ ∈ F \lambda\in F λ ∈ F
x + y = ∑ ( x i + y i ) α i , λ x = ∑ ( λ x i ) α i , x+y=\sum(x_i+y_i)\alpha_i,\qquad \lambda x=\sum(\lambda x_i)\alpha_i, x + y = ∑ ( x i + y i ) α i , λ x = ∑ ( λ x i ) α i ,
于是
T ( x + y ) = [ ( x 1 + y 1 ) + ( x 2 + y 2 ) + ( x 3 + y 3 ) ] α 1 + [ ( x 2 + y 2 ) + ( x 3 + y 3 ) ] α 2 + ( x 3 + y 3 ) α 3 = T ( x ) + T ( y ) , T(x+y)=\big[(x_1+y_1)+(x_2+y_2)+(x_3+y_3)\big]\alpha_1+\big[(x_2+y_2)+(x_3+y_3)\big]\alpha_2+(x_3+y_3)\alpha_3=T(x)+T(y), T ( x + y ) = [ ( x 1 + y 1 ) + ( x 2 + y 2 ) + ( x 3 + y 3 ) ] α 1 + [ ( x 2 + y 2 ) + ( x 3 + y 3 ) ] α 2 + ( x 3 + y 3 ) α 3 = T ( x ) + T ( y ) ,
T ( λ x ) = ( λ x 1 + λ x 2 + λ x 3 ) α 1 + ( λ x 2 + λ x 3 ) α 2 + λ x 3 α 3 = λ T ( x ) . T(\lambda x)=(\lambda x_1+\lambda x_2+\lambda x_3)\alpha_1+(\lambda x_2+\lambda x_3)\alpha_2+\lambda x_3\alpha_3=\lambda T(x). T ( λ x ) = ( λ x 1 + λ x 2 + λ x 3 ) α 1 + ( λ x 2 + λ x 3 ) α 2 + λ x 3 α 3 = λ T ( x ) .
故 T T T V V V (2) 代入 k 1 = 2 , k 2 = 1 , k 3 = 3 k_1=2,k_2=1,k_3=3 k 1 = 2 , k 2 = 1 , k 3 = 3
T ( β 0 ) = ( 2 + 1 + 3 ) α 1 + ( 1 + 3 ) α 2 + 3 α 3 = 6 α 1 + 4 α 2 + 3 α 3 . T(\beta_0)=(2+1+3)\alpha_1+(1+3)\alpha_2+3\alpha_3=6\alpha_1+4\alpha_2+3\alpha_3 . T ( β 0 ) = ( 2 + 1 + 3 ) α 1 + ( 1 + 3 ) α 2 + 3 α 3 = 6 α 1 + 4 α 2 + 3 α 3 .
例 2.2.3 / 2.2.4 的验证套路
以后遇到「微分变换 / 积分变换」,直接称呼、不再逐一验证(00:34:15 老师语)。要验证也不难:这两条要求落到微分与积分上,都只是微积分里的基本运算律。
定义里的两条只保证 T T T p p p
定理 2.2.1 · 保持线性组合
设 T T T F F F V V V W W W α 1 , ⋯ , α p \alpha_1,\cdots,\alpha_p α 1 , ⋯ , α p V V V k 1 , ⋯ , k p ∈ F k_1,\cdots,k_p\in F k 1 , ⋯ , k p ∈ F
T ( k 1 α 1 + ⋯ + k p α p ) = k 1 T ( α 1 ) + ⋯ + k p T ( α p ) . T(k_1\alpha_1+\cdots+k_p\alpha_p)=k_1T(\alpha_1)+\cdots+k_pT(\alpha_p). T ( k 1 α 1 + ⋯ + k p α p ) = k 1 T ( α 1 ) + ⋯ + k p T ( α p ) .
证明(对 p p p
p = 1 p=1 p = 1 p − 1 p-1 p − 1 p p p
T ( k 1 α 1 + ⋯ + k p α p ) = T [ ( k 1 α 1 + ⋯ + k p − 1 α p − 1 ) + k p α p ] = 可加 T ( k 1 α 1 + ⋯ + k p − 1 α p − 1 ) + T ( k p α p ) T(k_1\alpha_1+\cdots+k_p\alpha_p)=T\big[(k_1\alpha_1+\cdots+k_{p-1}\alpha_{p-1})+k_p\alpha_p\big]\overset{\text{可加}}{=}T(k_1\alpha_1+\cdots+k_{p-1}\alpha_{p-1})+T(k_p\alpha_p) T ( k 1 α 1 + ⋯ + k p α p ) = T [ ( k 1 α 1 + ⋯ + k p − 1 α p − 1 ) + k p α p ] = 可加 T ( k 1 α 1 + ⋯ + k p − 1 α p − 1 ) + T ( k p α p )
= 归纳 ( k 1 T ( α 1 ) + ⋯ + k p − 1 T ( α p − 1 ) ) + k p T ( α p ) . ■ \overset{\text{归纳}}{=}(k_1T(\alpha_1)+\cdots+k_{p-1}T(\alpha_{p-1}))+k_pT(\alpha_p).\qquad\blacksquare = 归纳 ( k 1 T ( α 1 ) + ⋯ + k p − 1 T ( α p − 1 )) + k p T ( α p ) . ■
∎ 老师强调(00:53:05–00:53:15):「不管 α 1 , ⋯ , α p \alpha_1,\cdots,\alpha_p α 1 , ⋯ , α p ,上式均成立。」不要求 α \alpha α 一组基 上的作用完全确定;因为任何向量都是基的线性组合,用 定理 2.2.1 一算即得。
推论 2.2.1 · 四条常用性质
设 T T T V V V W W W
T ( θ ) = θ ′ T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = θ ′ θ ∈ V \boldsymbol{\theta}\in V θ ∈ V θ ′ ∈ W \boldsymbol{\theta}'\in W θ ′ ∈ W 零元映到零元 );T ( − x ) = − T ( x ) T(-x)=-T(x) T ( − x ) = − T ( x ) ∀ x ∈ V \forall x\in V ∀ x ∈ V
同一个推论还补上两条:
若 α 1 , ⋯ , α p \alpha_1,\cdots,\alpha_p α 1 , ⋯ , α p V V V 线性相关 向量,则 T ( α 1 ) , ⋯ , T ( α p ) T(\alpha_1),\cdots,T(\alpha_p) T ( α 1 ) , ⋯ , T ( α p ) W W W 线性相关 向量;
若 T ( α 1 ) , ⋯ , T ( α p ) T(\alpha_1),\cdots,T(\alpha_p) T ( α 1 ) , ⋯ , T ( α p ) W W W 无关 向量,则 α 1 , ⋯ , α p \alpha_1,\cdots,\alpha_p α 1 , ⋯ , α p V V V
证明
(1) T ( θ ) = T ( 0 ⋅ θ ) = 0 ⋅ T ( θ ) = θ ′ T(\boldsymbol{\theta})=T(0\cdot\boldsymbol{\theta})=0\cdot T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = T ( 0 ⋅ θ ) = 0 ⋅ T ( θ ) = θ ′ T ( − x ) = T ( ( − 1 ) x ) = ( − 1 ) T ( x ) = − T ( x ) T(-x)=T((-1)x)=(-1)T(x)=-T(x) T ( − x ) = T (( − 1 ) x ) = ( − 1 ) T ( x ) = − T ( x ) 定义 1.3.1 )存在不全为零 的 k 1 , ⋯ , k p k_1,\cdots,k_p k 1 , ⋯ , k p k 1 α 1 + ⋯ + k p α p = θ k_1\alpha_1+\cdots+k_p\alpha_p=\boldsymbol{\theta} k 1 α 1 + ⋯ + k p α p = θ T T T 定理 2.2.1 、性质 (1):
k 1 T ( α 1 ) + ⋯ + k p T ( α p ) = T ( θ ) = θ ′ k_1T(\alpha_1)+\cdots+k_pT(\alpha_p)=T(\boldsymbol{\theta})=\boldsymbol{\theta}' k 1 T ( α 1 ) + ⋯ + k p T ( α p ) = T ( θ ) = θ ′
——系数 k i k_i k i 逆否命题 (课件把两者并列写出,考试常考「哪个方向成立」)。∎
∎ 注 1:线性映射必须保持原点不动(00:57:04)
「它把零元素映射到(新空间的)零元素上;但没有说非零元素不能映到零元素 ——有可能把一些非零元素也映到零元素。」这个「非零也能映成零」的现象,正是后面零空间 N ( T ) N(T) N ( T )
逆命题不真(00:58:44–01:03:20)
性质 (3) 说的是「相关组的像仍相关 」;反过来「像相关 ⟹ 原像组相关」不成立 ——零映射把任何组(包括无关组)都映成零组。这引出下一问:「什么条件下线性无关组的像也线性无关 ?」
定理 2.2.2 · 单射判据(当且仅当)
设 T T T F F F n n n V V V m m m W W W 当且仅当 T T T V V V W W W
注 1 :线性映射不一定将一组基映射为像空间的一组基。
注 2 :α 1 , ⋯ , α p \alpha_1,\cdots,\alpha_p α 1 , ⋯ , α p V V V p < n p<n p < n T ( α 1 ) , ⋯ , T ( α p ) T(\alpha_1),\cdots,T(\alpha_p) T ( α 1 ) , ⋯ , T ( α p ) 不一定 说明 T T T
证明(两个方向,01:04:17–01:11:01)
(⟸ 无关组的像无关,用反证) :设 T T T α 1 , ⋯ , α n \alpha_1,\cdots,\alpha_n α 1 , ⋯ , α n V V V k 1 T ( α 1 ) + ⋯ + k n T ( α n ) = θ ′ k_1T(\alpha_1)+\cdots+k_nT(\alpha_n)=\boldsymbol{\theta}' k 1 T ( α 1 ) + ⋯ + k n T ( α n ) = θ ′ 定理 2.2.1 与 推论 2.2.1 (1),
T ( k 1 α 1 + ⋯ + k n α n ) = θ ′ = T ( θ ) . T(k_1\alpha_1+\cdots+k_n\alpha_n)=\boldsymbol{\theta}'=T(\boldsymbol{\theta}). T ( k 1 α 1 + ⋯ + k n α n ) = θ ′ = T ( θ ) .
T T T k 1 α 1 + ⋯ + k n α n = θ k_1\alpha_1+\cdots+k_n\alpha_n=\boldsymbol{\theta} k 1 α 1 + ⋯ + k n α n = θ α \alpha α k i = 0 k_i=0 k i = 0
(⟹ 保无关 ⟹ 单射) :设 T T T T T T x ≠ y x\neq y x = y T ( x ) = T ( y ) T(x)=T(y) T ( x ) = T ( y ) V V V α 1 , ⋯ , α n \alpha_1,\cdots,\alpha_n α 1 , ⋯ , α n x = ∑ x i α i x=\sum x_i\alpha_i x = ∑ x i α i y = ∑ y i α i y=\sum y_i\alpha_i y = ∑ y i α i
θ ′ = T ( x ) − T ( y ) = T ( x − y ) = ( x 1 − y 1 ) T ( α 1 ) + ⋯ + ( x n − y n ) T ( α n ) , \boldsymbol{\theta}'=T(x)-T(y)=T(x-y)=(x_1-y_1)T(\alpha_1)+\cdots+(x_n-y_n)T(\alpha_n), θ ′ = T ( x ) − T ( y ) = T ( x − y ) = ( x 1 − y 1 ) T ( α 1 ) + ⋯ + ( x n − y n ) T ( α n ) ,
而 x − y ≠ θ x-y\neq\boldsymbol{\theta} x − y = θ x i − y i x_i-y_i x i − y i T ( α 1 ) , ⋯ , T ( α n ) T(\alpha_1),\cdots,T(\alpha_n) T ( α 1 ) , ⋯ , T ( α n ) T T T
∎ 判据证完。老师把这段论证压缩成一句(01:10:55):「如果有线性无关(组的像线性无关)这个性质,那这个 T T T ,必要性证完。」
推论 2.2.2 · 维数相同 + 单射 ⟹ 双射
设线性空间 V V V W W W 维数相同 ,且 T T T V V V W W W T T T V V V 基 的像是 W W W 基 ,此时映射 T T T 双射 。
维数陷阱(01:11:17–01:14:23,老师郑重提醒)
要点分两层,别混在一起:
单射判据(定理 2.2.2 )本身不需要任何维数假设 ——它说的是「T T T ⟺ \iff ⟺ dim W < dim V \dim W<\dim V dim W < dim V 同时为假 (此时不存在单射),等价依然成立。推论 2.2.2 则必须先设 dim V = dim W \dim V=\dim W dim V = dim W :dim W < dim V \dim W<\dim V dim W < dim V 基的像也是基 」(从而双射)的关键补丁。
做题时先看题目给没给同维条件,不要默认。
定义、例子、性质与判据都有了,接下来换个角度「数」线性映射:把 V → W V\to W V → W
定义 2.2.2 / 2.2.3 · 线性映射的加法与数乘
设 T 1 , T 2 ∈ L ( V , W ) T_1,T_2\in L(V,W) T 1 , T 2 ∈ L ( V , W ) L ( V , W ) L(V,W) L ( V , W ) V V V W W W 所有线性映射的集合 )。
加法 :( T 1 + T 2 ) ( x ) = T 1 ( x ) + T 2 ( x ) (T_1+T_2)(x)=T_1(x)+T_2(x) ( T 1 + T 2 ) ( x ) = T 1 ( x ) + T 2 ( x ) ∀ x ∈ V \forall x\in V ∀ x ∈ V + + + W W W 数乘 :( λ T ) ( x ) = λ ⋅ T ( x ) (\lambda T)(x)=\lambda\cdot T(x) ( λ T ) ( x ) = λ ⋅ T ( x ) ∀ x ∈ V , λ ∈ F \forall x\in V,\ \lambda\in F ∀ x ∈ V , λ ∈ F ⋅ \cdot ⋅ W W W
两套运算有了,L ( V , W ) L(V,W) L ( V , W )
证明(验证八条公理的思路)
加法与数乘都「逐点借用 W W W W W W x ↦ θ ′ x\mapsto\boldsymbol{\theta}' x ↦ θ ′ T T T − T -T − T x ↦ − T ( x ) x\mapsto-T(x) x ↦ − T ( x ) x x x 封闭性 :T 1 + T 2 T_1+T_2 T 1 + T 2 λ T \lambda T λ T 线性映射 ——因为它们逐点线性(这也是必须先验证的部分)。∎
∎ 空间有了,下一个问题自然是它有多大——课件思考题问的正是 dim L ( V , W ) \dim L(V,W) dim L ( V , W )
例 2.2.A(课堂展开)· R 2 → R 3 \mathbb R^2\to\mathbb R^3 R 2 → R 3 3 × 2 3\times2 3 × 2
「从 R 2 \mathbb R^2 R 2 R 3 \mathbb R^3 R 3 A A A A A A 3 × 2 3\times2 3 × 2 R 2 \mathbb R^2 R 2 R 3 \mathbb R^3 R 3
[ x 1 x 2 ] → T [ y 1 y 2 y 3 ] , A 3 × 2 [ x 1 x 2 ] = [ y 1 y 2 y 3 ] . \begin{bmatrix}x_1\\ x_2\end{bmatrix}\xrightarrow{\ T\ }\begin{bmatrix}y_1\\ y_2\\ y_3\end{bmatrix},\qquad A^{3\times2}\begin{bmatrix}x_1\\ x_2\end{bmatrix}=\begin{bmatrix}y_1\\ y_2\\ y_3\end{bmatrix}. [ x 1 x 2 ] T y 1 y 2 y 3 , A 3 × 2 [ x 1 x 2 ] = y 1 y 2 y 3 .
老师给出一句通俗概括(01:17:54):「线性映射是什么?线性映射其实就是一个矩阵。线性映射空间是什么?其实就是一个矩阵空间 」——「当然只是通俗地理解,严格说:取定基之后」。因此
dim L ( R 2 , R 3 ) = 3 × 2 = 6 , \dim L(\mathbb R^2,\mathbb R^3)=3\times2=6, dim L ( R 2 , R 3 ) = 3 × 2 = 6 ,
与矩阵空间 R 3 × 2 \mathbb R^{3\times2} R 3 × 2 E 11 , E 12 , E 21 , E 22 , E 31 , E 32 E_{11},E_{12},E_{21},E_{22},E_{31},E_{32} E 11 , E 12 , E 21 , E 22 , E 31 , E 32 6 6 6 2 2 2 dim L ( V , W ) = dim V ⋅ dim W \dim L(V,W)=\dim V\cdot\dim W dim L ( V , W ) = dim V ⋅ dim W
例 2.2.B(课堂展开)· T ( X ) = A X B T(X)=AXB T ( X ) = A XB
把 2 × 2 2\times2 2 × 2 3 × 3 3\times3 3 × 3 A A A 3 × 2 3\times2 3 × 2 B B B 2 × 3 2\times3 2 × 3 T ( X ) = A X B T(X)=AXB T ( X ) = A XB A A A 6 6 6 B B B 6 6 6 12 12 12
这里有一处容易踩的混淆: 12 12 12 不是 这族映射的维数。λ ≠ 0 \lambda\neq0 λ = 0 ( λ A , λ − 1 B ) (\lambda A,\lambda^{-1}B) ( λ A , λ − 1 B ) ( A , B ) (A,B) ( A , B ) 同一个 T ( X ) = A X B T(X)=AXB T ( X ) = A XB ( A , B ) (A,B) ( A , B ) 11 11 11 L ( V , W ) L(V,W) L ( V , W ) dim V ⋅ dim W \dim V\cdot\dim W dim V ⋅ dim W 只能通俗地理解 (L ( V , W ) L(V,W) L ( V , W )
到此为止都是从外部看线性映射:定义它、清点它、把全体装进 L ( V , W ) L(V,W) L ( V , W ) T T T
定理 2.2.4 · 值空间(像空间)与核空间(零空间)
设 T ∈ L ( V , W ) T\in L(V,W) T ∈ L ( V , W )
N ( T ) = { x ∈ V ∣ T ( x ) = θ ′ } , R ( T ) = { y ∈ W ∣ ∃ x ∈ V , y = T ( x ) } = T ( V ) . N(T)=\{x\in V\mid T(x)=\boldsymbol{\theta}'\},\qquad R(T)=\{y\in W\mid \exists\,x\in V,\ y=T(x)\}=T(V). N ( T ) = { x ∈ V ∣ T ( x ) = θ ′ } , R ( T ) = { y ∈ W ∣ ∃ x ∈ V , y = T ( x )} = T ( V ) .
(量词要看清:R ( T ) R(T) R ( T ) x x x 存在 的,不是「对一切 x x x y y y 某一个 x x x θ ∈ V \boldsymbol{\theta}\in V θ ∈ V θ ′ ∈ W \boldsymbol{\theta}'\in W θ ′ ∈ W N ( T ) N(T) N ( T ) θ ′ \boldsymbol{\theta}' θ ′
则 N ( T ) N(T) N ( T ) V V V 子空间 、R ( T ) R(T) R ( T ) W W W 子空间 。称 N ( T ) N(T) N ( T ) T T T 核空间 (或零空间 ),R ( T ) R(T) R ( T ) T T T 像空间 (或值空间 );并称 dim N ( T ) \dim N(T) dim N ( T ) T T T 零度 (或亏 ),dim R ( T ) \dim R(T) dim R ( T ) T T T 秩 。
子空间性的证明(课堂口述要点,[1.2](../ch01/sec12.md) 判定定理的直接应用)
先看 N ( T ) ⊂ V N(T)\subset V N ( T ) ⊂ V θ ∈ N ( T ) \boldsymbol{\theta}\in N(T) θ ∈ N ( T ) T ( θ ) = θ ′ T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = θ ′ x , y ∈ N ( T ) x,y\in N(T) x , y ∈ N ( T ) λ , μ ∈ F \lambda,\mu\in F λ , μ ∈ F T ( λ x + μ y ) = λ T ( x ) + μ T ( y ) = θ ′ T(\lambda x+\mu y)=\lambda T(x)+\mu T(y)=\boldsymbol{\theta}' T ( λ x + μ y ) = λ T ( x ) + μ T ( y ) = θ ′ λ x + μ y ∈ N ( T ) \lambda x+\mu y\in N(T) λ x + μ y ∈ N ( T ) R ( T ) ⊂ W R(T)\subset W R ( T ) ⊂ W T ( x ) , T ( y ) T(x),T(y) T ( x ) , T ( y ) T ( λ x + μ y ) = λ T ( x ) + μ T ( y ) T(\lambda x+\mu y)=\lambda T(x)+\mu T(y) T ( λ x + μ y ) = λ T ( x ) + μ T ( y )
∎ 命名由来(01:25:49–01:26:26)
「N ( T ) N(T) N ( T ) V V V 零度 ;R ( T ) R(T) R ( T ) 秩 ——它和矩阵的秩 是非常相似的。」(提问:矩阵 A A A dim N ( T ) = dim N ( A ) \dim N(T)=\dim N(A) dim N ( T ) = dim N ( A ) dim R ( T ) = rank A \dim R(T)=\operatorname{rank}A dim R ( T ) = rank A 定理 2.3.6 ),「矩阵的秩」与「映射的秩」自此是同一件事的两种说法。
定理 2.2.5 · 亏加秩定理(维数公式)
设 T ∈ L ( V , W ) T\in L(V,W) T ∈ L ( V , W )
dim N ( T ) + dim R ( T ) = dim V , \dim N(T)+\dim R(T)=\dim V, dim N ( T ) + dim R ( T ) = dim V ,
即线性映射 T T T V V V
证明(基扩充——课堂上证到一半下课,此处按老师的路线补完)
记 dim V = n \dim V=n dim V = n
第一步(取 V V V :设 ε 1 , ⋯ , ε n \varepsilon_1,\cdots,\varepsilon_n ε 1 , ⋯ , ε n V V V
第二步(取 N ( T ) N(T) N ( T ) :设 dim N ( T ) = m ≤ n \dim N(T)=m\le n dim N ( T ) = m ≤ n N ( T ) N(T) N ( T ) h 1 , ⋯ , h m h_1,\cdots,h_m h 1 , ⋯ , h m 基扩充定理 (板书 90:18 的图解正对应此步)扩充为 V V V
h 1 , ⋯ , h m , h m + 1 , ⋯ , h n . h_1,\cdots,h_m,\ h_{m+1},\cdots,h_n . h 1 , ⋯ , h m , h m + 1 , ⋯ , h n .
第三步(R ( T ) R(T) R ( T ) n − m n-m n − m :V V V β = k 1 h 1 + ⋯ + k n h n \beta=k_1h_1+\cdots+k_nh_n β = k 1 h 1 + ⋯ + k n h n T T T
T ( β ) = k 1 T ( h 1 ) + ⋯ + k m T ( h m ) + k m + 1 T ( h m + 1 ) + ⋯ + k n T ( h n ) = k m + 1 T ( h m + 1 ) + ⋯ + k n T ( h n ) , T(\beta)=k_1T(h_1)+\cdots+k_mT(h_m)+k_{m+1}T(h_{m+1})+\cdots+k_nT(h_n)=k_{m+1}T(h_{m+1})+\cdots+k_nT(h_n), T ( β ) = k 1 T ( h 1 ) + ⋯ + k m T ( h m ) + k m + 1 T ( h m + 1 ) + ⋯ + k n T ( h n ) = k m + 1 T ( h m + 1 ) + ⋯ + k n T ( h n ) ,
(用了 h 1 , ⋯ , h m ∈ N ( T ) h_1,\cdots,h_m\in N(T) h 1 , ⋯ , h m ∈ N ( T ) m m m
R ( T ) = span { T ( h m + 1 ) , ⋯ , T ( h n ) } . R(T)=\operatorname{span}\{T(h_{m+1}),\cdots,T(h_n)\}. R ( T ) = span { T ( h m + 1 ) , ⋯ , T ( h n )} .
第四步(后 n − m n-m n − m :若
c m + 1 T ( h m + 1 ) + ⋯ + c n T ( h n ) = θ ′ , c_{m+1}T(h_{m+1})+\cdots+c_nT(h_n)=\boldsymbol{\theta}', c m + 1 T ( h m + 1 ) + ⋯ + c n T ( h n ) = θ ′ ,
由线性得 T ( c m + 1 h m + 1 + ⋯ + c n h n ) = θ ′ T(c_{m+1}h_{m+1}+\cdots+c_nh_n)=\boldsymbol{\theta}' T ( c m + 1 h m + 1 + ⋯ + c n h n ) = θ ′ c m + 1 h m + 1 + ⋯ + c n h n ∈ N ( T ) c_{m+1}h_{m+1}+\cdots+c_nh_n\in N(T) c m + 1 h m + 1 + ⋯ + c n h n ∈ N ( T ) N ( T ) N(T) N ( T ) c 1 , ⋯ , c m c_1,\cdots,c_m c 1 , ⋯ , c m
c m + 1 h m + 1 + ⋯ + c n h n = c 1 h 1 + ⋯ + c m h m , c_{m+1}h_{m+1}+\cdots+c_nh_n=c_1h_1+\cdots+c_mh_m, c m + 1 h m + 1 + ⋯ + c n h n = c 1 h 1 + ⋯ + c m h m ,
即 c 1 h 1 + ⋯ + c m h m − c m + 1 h m + 1 − ⋯ − c n h n = θ c_1h_1+\cdots+c_mh_m-c_{m+1}h_{m+1}-\cdots-c_nh_n=\boldsymbol{\theta} c 1 h 1 + ⋯ + c m h m − c m + 1 h m + 1 − ⋯ − c n h n = θ h 1 , ⋯ , h n h_1,\cdots,h_n h 1 , ⋯ , h n V V V c m + 1 = ⋯ = c n = 0 c_{m+1}=\cdots=c_n=0 c m + 1 = ⋯ = c n = 0 T ( h m + 1 ) , ⋯ , T ( h n ) T(h_{m+1}),\cdots,T(h_n) T ( h m + 1 ) , ⋯ , T ( h n ) R ( T ) R(T) R ( T )
dim R ( T ) = n − m = dim V − dim N ( T ) . ■ \dim R(T)=n-m=\dim V-\dim N(T).\qquad\blacksquare dim R ( T ) = n − m = dim V − dim N ( T ) . ■
∎ 定理在说什么
「V V V n n n m m m T T T N ( T ) N(T) N ( T ) n − m n-m n − m R ( T ) R(T) R ( T ) 死的部分 + 活的部分 = 全部 。它是判断「单射 / 满射 / 同构」的定量工具(T T T ⟺ dim N ( T ) = 0 \iff\dim N(T)=0 ⟺ dim N ( T ) = 0 T T T ⟺ dim R ( T ) = dim W \iff\dim R(T)=\dim W ⟺ dim R ( T ) = dim W 定理 2.3.6 ),此后的秩理论与特征值讨论都建立在它上面。
一条主线 :定义(两条件)→ 例子(几何 / 微分 / 积分 / 投影 / 两组基 / 矩阵诱导)→ 性质(保持组合、T ( θ ) = θ ′ T(\boldsymbol{\theta})=\boldsymbol{\theta}' T ( θ ) = θ ′ L ( V , W ) L(V,W) L ( V , W ) dim V ⋅ dim W \dim V\cdot\dim W dim V ⋅ dim W N ( T ) N(T) N ( T ) R ( T ) R(T) R ( T ) 一个记号提醒 :dim L ( V , W ) \dim L(V,W) dim L ( V , W ) L L L L ( V , W ) \mathcal L(V,W) L ( V , W )
常见错误清单 · 自查三条
验证线性时只验一条 ——可加性与齐次性缺一不可。两个方向都有反例:T ( x , y ) = { x 2 / y , y ≠ 0 0 , y = 0 T(x,y)=\begin{cases}x^2/y,&y\neq0\\0,&y=0\end{cases} T ( x , y ) = { x 2 / y , 0 , y = 0 y = 0 R 2 → R \mathbb R^2\to\mathbb R R 2 → R 齐次性 (T ( t x , t y ) = t T ( x , y ) T(tx,ty)=t\,T(x,y) T ( t x , t y ) = t T ( x , y ) T ( 1 , 2 ) + T ( 1 , 1 ) = 3 2 ≠ 4 3 = T ( 2 , 3 ) T(1,2)+T(1,1)=\frac32\neq\frac43=T(2,3) T ( 1 , 2 ) + T ( 1 , 1 ) = 2 3 = 3 4 = T ( 2 , 3 ) T ( x ) = ∥ x ∥ T(x)=\|x\| T ( x ) = ∥ x ∥ 齐次性 也不满足(∥ − x ∥ = ∥ x ∥ ≠ − ∥ x ∥ \|-x\|=\|x\|\neq-\|x\| ∥ − x ∥ = ∥ x ∥ = − ∥ x ∥ x ≠ θ x\neq\boldsymbol{\theta} x = θ
单射判据的两个方向记混——「保无关 ⟹ 单射」需要定义域整个基 上的无关性(注 2 的反例:p < n p<n p < n
用「维数相同 + 单射」得双射时忘了同维数 前提(维数陷阱 )。
即时自测(不看上文,3 分钟)
写出线性映射定义的两条,并写出合并形式。
T ( x ) = ∥ x ∥ T(x)=\|x\| T ( x ) = ∥ x ∥ R n → R \mathbb R^n\to\mathbb R R n → R T : R 2 → R 2 T:\mathbb R^2\to\mathbb R^2 T : R 2 → R 2 T ( x ) = [ x 1 , − x 2 ] T T(x)=[x_1,-x_2]^{\mathrm T} T ( x ) = [ x 1 , − x 2 ] T N ( T ) N(T) N ( T ) R ( T ) R(T) R ( T ) 平移 T ( x ) = x + a T(x)=x+a T ( x ) = x + a a ≠ 0 a\neq0 a = 0
解答 · 即时自测
可加性 + 齐次性;T ( a x + b y ) = a T ( x ) + b T ( y ) T(ax+by)=aT(x)+bT(y) T ( a x + b y ) = a T ( x ) + b T ( y )
不是。齐次性 先不成立:取 x ≠ θ x\neq\boldsymbol{\theta} x = θ T ( − x ) = ∥ − x ∥ = ∥ x ∥ ≠ − ∥ x ∥ = − T ( x ) T(-x)=\|-x\|=\|x\|\neq-\|x\|=-T(x) T ( − x ) = ∥ − x ∥ = ∥ x ∥ = − ∥ x ∥ = − T ( x ) ∥ x + y ∥ ≤ ∥ x ∥ + ∥ y ∥ \|x+y\|\le\|x\|+\|y\| ∥ x + y ∥ ≤ ∥ x ∥ + ∥ y ∥
N ( T ) = { θ } N(T)=\{\boldsymbol{\theta}\} N ( T ) = { θ } 0 0 0 R ( T ) = R 2 R(T)=\mathbb R^2 R ( T ) = R 2 2 2 2 0 + 2 = 2 = dim R 2 0+2=2=\dim\mathbb R^2 0 + 2 = 2 = dim R 2 T ( θ ) = a ≠ θ T(\boldsymbol{\theta})=a\neq\boldsymbol{\theta} T ( θ ) = a = θ 推论 2.2.1 (1)(线性映射必须保持原点不动)。